나비랑
AI 답변엔진 최적화(AEO) 전문기업 사이트 — 기획부터 측정 방법론 설계까지
navirang-ai.com ↗AEO(Answer Engine Optimization)를 파는 회사의 사이트를, 그 회사가 스스로 주장하는 기준으로 만들었다. "측정 조건을 공개하지 않은 인용률은 검증할 수 없다"는 문장을 다른 업체에 요구하려면, 우리부터 지켜야 했다.
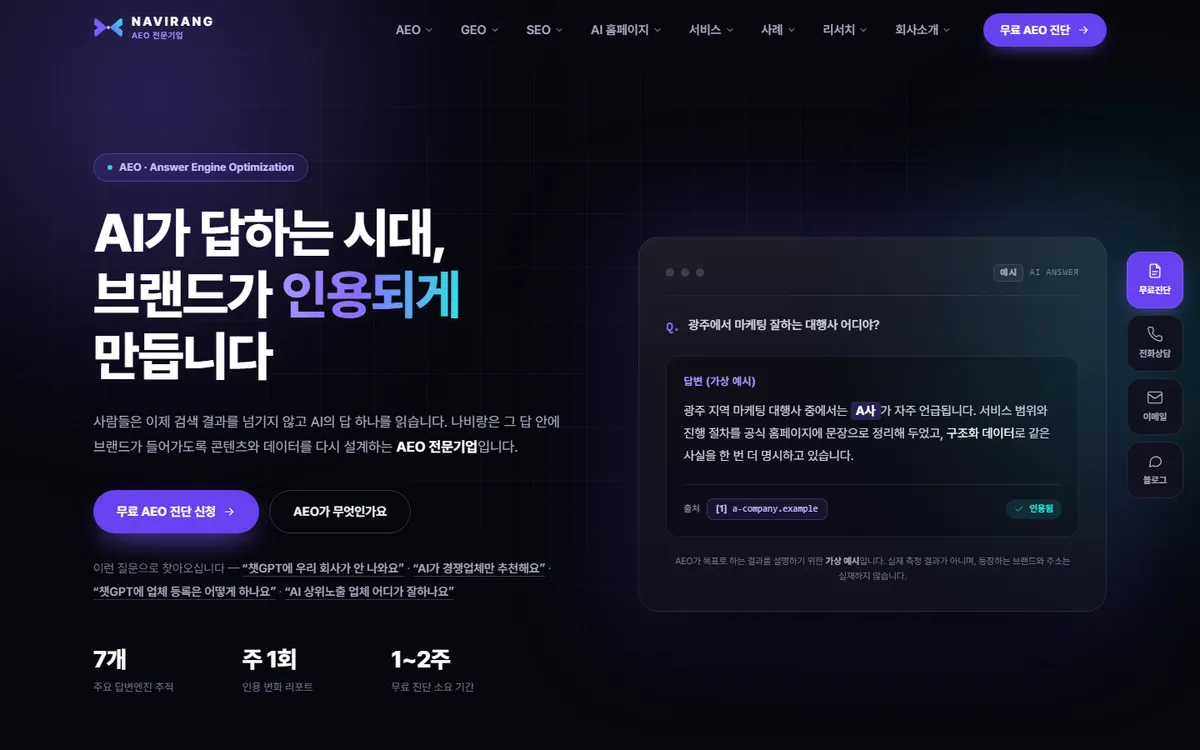
- 01
측정 방법론을 공개하는 이유
질문 40개 × 답변엔진 7개(ChatGPT·Gemini·Perplexity·Claude·네이버 AI 검색·Copilot·Google AI 개요) = 280셀을 관측 단위로 고정했다. 언급·인용·추천을 나눠서 기록하고, 분모는 측정 시작 시점에 고정해 이후 바꾸지 않는다. 실제로 2026-08-11에 SearchGPT를 대상 엔진 목록에서 뺐는데(ChatGPT Search로 흡수돼 폐기된 이름이라 별도로 세면 중복 계수가 된다), 그건 기준선 측정 착수 전이라 가능했던 정정이었다 — 첫 셀이 채워진 뒤에는 분모를 못 바꾼다는 규칙을 스스로 만든 뒤이기 때문이다.
- 02
전국 340건을 직접 조사했다
"지역 마케팅 대행사" 같은 질의에서 네이버가 블로그와 홈페이지를 어떤 비율로 보여주는지 궁금해서, 전국 17개 시도 × 질의 2종의 웹문서 상위 10건, 총 340건을 손으로 분류해 CSV로 공개했다. 측정 시점의 스냅샷이라 재측정해도 그 파일은 덮어쓰지 않는다 — 다시 재면 새 날짜의 새 파일로 낸다. 그래야 그 주소를 인용한 외부 문서가 어느 시점 값을 인용했는지 계속 알 수 있다.
- 03
"AEO"라는 말 자체가 문제였다
한국에서 AEO는 관세청의 수출입안전관리우수업체(Authorized Economic Operator)로도 강하게 쓰인다. 핵심 페이지 첫 등장에서 반드시 Answer Engine Optimization을 풀어 쓰고, 조직 스키마에도 중의성 해소 문장을 심었다. 동시에 "AI 상위노출"처럼 실제 사람들이 검색창에 치는 구어 표현이 사이트 어디에도 없다는 것도 찾아냈다 — 전문 용어(AEO)만 있고 사람들이 실제로 쓰는 말이 없으면, 그 말로 검색하는 사람에게는 이 사이트가 안 보인다. 홈 title·keywords·엔티티 knowsAbout·본문 진입 문구까지 그 층을 새로 연결했다.
- 04
meta description 221장을 다시 잰 일
빙 웹마스터 도구는 설명이 짧다고, Ahrefs는 같은 문서들을 길다고 지적했다. 둘 다 옳은 지적이라 두 기준을 모두 만족하는 110~158자 밴드를 정하고, 문장 경계에서만 자르는 규칙을 만들어 221장 전부를 그 밴드 안으로 넣었다. 자르는 과정에서 두 번 더 틀렸다 — 이 이야기는 기록에 자세히 적었다.